Model Card — Além do Placar (T006–T007)
Status: execução histórica real (T006) realizada pelo responsável pelo projeto, com fonte OpenFootball CC0 de 2018–2025 e holdout exclusivo de 2025. Não há dados de 2026.
Explicabilidade e avaliação científica (T007): código, testes e execução real entregues. Os números abaixo vêm de data/predictions/cientifica/relatorio_cientifico.md.
Modelo e alvo
- Alvo:
media_pontos_futuros_5, média de pontos nas cinco partidas seguintes da mesma equipe e temporada, calculada após o jogo de referência (pós-jogo). - Horizonte: 5 partidas. Observações com horizonte incompleto não recebem alvo.
- Candidatos: M00 média recente de 5 partidas (baseline); M01 Ridge; M02 Random Forest; M03 HistGradientBoosting. B01 média histórica do treino é referência adicional.
- Seleção: modelo ML só é escolhido com ganho mínimo de 2% no MAE médio de validação e sem piora superior a 10% em nenhum ano. Caso contrário, M00 é mantido.
Atributos (FEATURES)
media_pontos_3, media_pontos_5, media_pontos_10, media_saldo_gols_3, media_saldo_gols_5, media_saldo_gols_10, desvio_pontos_5, media_pontos_mandante_historico, media_pontos_visitante_historico, jogos_acumulados, dias_descanso, mando.
Identificadores, pontos e gols da partida atual, rodada, alvo e fim_alvo não são entradas.
Validação e corte
- Backtesting por temporadas com janela expansiva: validação em 2022–2024 e holdout em 2025.
- Treino de cada fold: somente linhas com data de referência e
fim_alvoestritamente anteriores à primeira data do teste. - 2026 não é processado.
- O holdout não participa da seleção. O modelo escolhido é reajustado uma única vez com dados anteriores a 2025.
- Previsões são cortadas no intervalo [0, 3].
Intervalo de previsão
Intervalo de 90% empírico: quantil de 90% dos erros absolutos das previsões de validação do modelo escolhido. A cobertura é medida no holdout. Não há garantia estatística, porque os alvos de partidas consecutivas se sobrepõem no tempo.
Explicabilidade e avaliação científica (T007)
- Função:
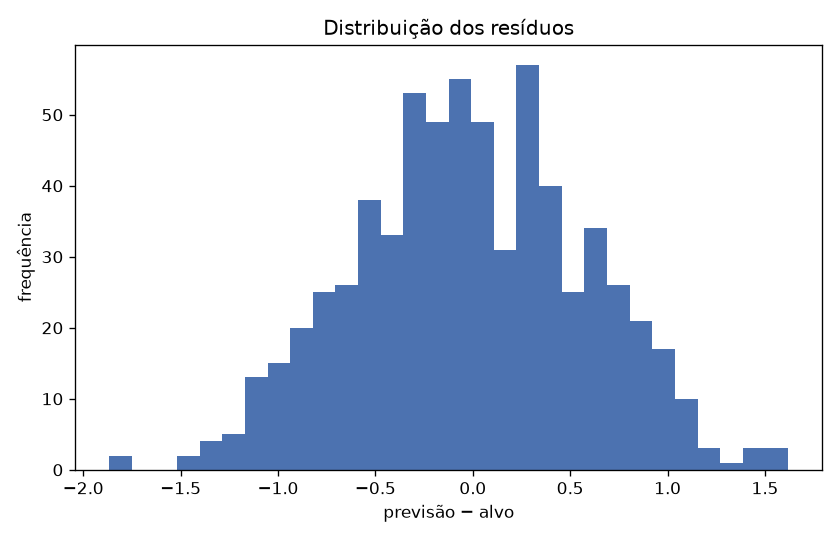
avaliar_cientificamenteemsrc/evaluation/cientifica.py(versãoT007-1.0). Consome a saída deexecutar_backteste usa o modelo congelado em memória. Não há treino, reajuste nem carregamento de pickle externo. - Resíduos: resíduo = previsão − alvo. São reportados MAE, RMSE, viés, cobertura do intervalo e n, no holdout de 2025, por equipe e por temporada. Diferenças entre equipes com n diferente não são ranking de mérito.
- Erros extremos: as 10 maiores observações por erro absoluto.
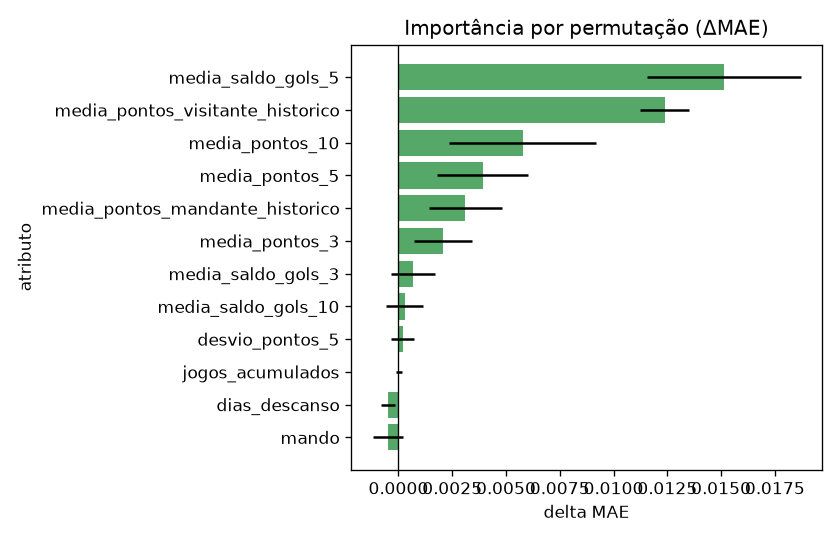
- Importância por permutação: cada atributo é embaralhado no holdout congelado, com seed 42 e 5 repetições por padrão. ΔMAE = MAE embaralhado − MAE original. Valores negativos são mantidos. É medida preditiva e exploratória: não é estudo causal nem ablação, e atributos correlacionados podem dividir a importância. Não altera seleção, parâmetros ou treino.
- Comparação: modelo selecionado contra M00 no holdout. B01 (média histórica global do treino) aparece somente na validação.
- Hipóteses:
- H01 (indicadores recentes): resultado observado nesta comparação, sem generalização.
- H02 (médias móveis contra médias históricas): comparação específica de M00 contra B01 na validação. B01 não é média por clube.
- H03 (mando) e H04 (volatilidade e saldo de gols): não conclusivas. A importância é preditiva e exploratória.
- H05 (ML contra baseline): resultado observado nesta comparação, sem generalização para outras temporadas ou competições.
- H06 (xG): não avaliável. xG não está disponível e nenhum valor foi preenchido com zero.
- Não há valor-p, intervalo estatístico nem teste de significância para os erros.
- Saídas (pasta explícita):
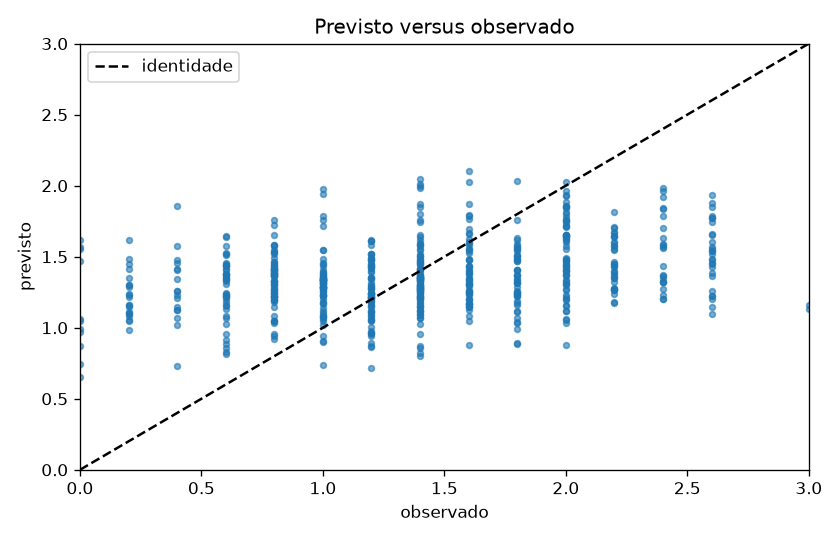
relatorio_cientifico.json,relatorio_cientifico.md,importancias.csv,residuos.parquete três PNGs (distribuição dos resíduos, previsto versus observado com linha de identidade, importância por permutação).
Resultados da execução T007
Fonte: data/predictions/cientifica/relatorio_cientifico.md (versão T007-1.0, seed 42, 5 repetições de permutação, holdout 2025 de 2025-03-29 a 2025-11-15).
| Métrica (holdout, n=660) | M01_ridge | M00_media_recente_5 |
|---|---|---|
| MAE | 0.478089 | 0.567091 |
| RMSE | 0.590887 | 0.722596 |
| Viés | -0.016830 | -0.001520 |
Diferença de MAE (selecionado menos baseline): -0.089002. Cobertura do intervalo de 90%: 91,21%.
Importância por permutação (ΔMAE médio, maiores): media_saldo_gols_5 +0.0151; media_pontos_visitante_historico +0.0124; media_pontos_10 +0.0058; media_pontos_5 +0.0039; media_pontos_mandante_historico +0.0031. Mando e dias de descanso ficaram próximos de zero ou negativos. É medida preditiva exploratória, não causal.
Hipóteses (resultado observado nesta comparação, sem generalização):
- H01 e H05: favoráveis. O Ridge supera o baseline no holdout.
- H02: desfavorável. Na validação, a média recente (MAE 0.604) ficou pior que a média histórica global do treino (MAE 0.515). A referência B01 não é média por clube.
- H03 e H04: não conclusivas.
- H06: não avaliável, pois xG não está disponível.
Erros extremos concentram-se em São Paulo, Bragantino e Vasco no segundo semestre de 2025. Os erros por equipe têm viés de sinal variado (por exemplo, SC Recife +0.52 e Mirassol -0.33), então não há ranking de mérito.
Limitações
- Dados observacionais e uma única competição; resultados não são causais.
- Avaliação em um único holdout temporal; amostra pequena por equipe.
- Alvos de partidas consecutivas se sobrepõem no tempo; as observações não são independentes.
- Previsões não são certezas nem recomendações de apostas.
- Qualquer resultado depende da fonte OpenFootball CC0 auditada (T002–T003).
Persistência e segurança
- Modelos são gravados com joblib apenas para objetos criados pelo projeto.
- Pickles externos nunca são carregados.
- Os experimentos são registrados em MLflow local (SQLite), sem servidor, nuvem ou credenciais.
Métricas
Resultados reais (660 observações de holdout com horizonte completo):
| Modelo | MAE | RMSE | Viés |
|---|---|---|---|
| M00_media_recente_5 | 0.567091 | 0.722596 | -0.001520 |
| M01_ridge | 0.478089 | 0.590887 | -0.016830 |
Modelo selecionado na validação: M01_ridge. MAE médio de validação 0.488755 contra 0.604116 do baseline recente. Cobertura empírica no holdout: 91.21%. Corte exclusivo do treino: 2025-03-29. O holdout não foi usado para escolher o modelo. Rastreamento local SQLite, run_id 1c65e28718854750b7d3f35b0c972fa1.
Reprodução
python -m pip install -e ".[test,lint]"
python -B -m pytest tests/unit/test_backtesting.py tests/unit/test_experimentos.py tests/unit/test_cientifica.py
Figuras da avaliação científica
Metodologia — Análise exploratória (T004)
Escopo: descrição estatística das tabelas Parquet geradas pela T003 (PRD seções 5.1 e 5.2).
Implementação: src/evaluation/exploratoria.py, notebook notebooks/01_exploratoria.ipynb.
1. Entrada
dim_equipes,dim_temporadas,fato_partidasefato_desempenho_equipesemdata/processed.carregar_basemonta uma linha por partida com colunaspartida_id,data_partida,temporada,competicao,equipe_mandante,equipe_visitante,gols_mandante,gols_visitante,resultado(H/D/A),rodadae os IDs correspondentes.- A rodada vem da observação de desempenho do mandante. Partidas sem essa observação recebem
rodadanulo, contado emqualidade.rodadas_ausentes.
2. Joins e validação
- Chaves primárias (
equipe_id,temporada_id,partida_id) devem ser únicas; caso contrário, há erro. - Os joins usam
validate="many_to_one"(eone_to_onepara a rodada). Chave sem correspondência gera erro, não valor nulo silencioso. resultadodeve ser coerente com os gols; gols ausentes geram erro.- Base vazia é rejeitada com a mensagem
base vazia.
3. Período
- Período candidato do PRD 2.2: 2015–2025.
- Período real validado: 2018–2025 (3.040 partidas, 380 por temporada, 20 clubes por temporada).
- A temporada 2026 é reservada para avaliação temporal final. O código a rejeita e não a processa.
- Dados sintéticos existem apenas nos testes (
tests/unit/test_exploratoria.py) e nunca são apresentados como dados reais.
4. Estatísticas produzidas (resumo_exploratorio)
- Número de partidas, equipes e temporadas (lista ordenada).
- Médias de gols (mandante, visitante e total) e distribuição H/D/A com quantidades e proporções.
- Agregados por temporada (partidas, gols totais, média de gols, H/D/A).
- Agregados por mando de campo, por equipe e por equipe e temporada: jogos, vitórias, empates, derrotas, gols pró e contra, saldo e pontos.
- Pontos seguem a regra 3/1/0 (PRD 5.2).
- Indicadores de qualidade: partidas duplicadas, confrontos repetidos na mesma data, datas e rodadas ausentes, mandante igual ao visitante e placares extremos (total de gols de 7 ou mais, limiar exploratório).
Anomalias são apenas listadas. Nenhum registro é removido automaticamente.
5. Saídas (exportar_analise)
resumo.json: JSON com ordenação estável e sem data de geração, portanto reproduzível.gols_por_temporada.png: média de gols por partida por temporada.distribuicao_resultados.png: quantidades e proporções H/D/A.pontos_por_equipe.png: pontos acumulados no período.- Os gráficos usam o backend Agg (sem interface gráfica) e as figuras são liberadas após a gravação.
6. Hipóteses do PRD (planos de investigação)
Estas hipóteses são planos. Nenhuma está confirmada nesta etapa. Os testes de hipótese dependem de modelagem (T005 a T007).
- H01 — indicadores recentes ajudam a prever a evolução futura. Plano: comparar médias móveis de pontos com o desempenho seguinte (T005/T006).
- H02 — médias móveis superam médias históricas isoladas. Plano: comparação de erro de previsão em backtesting temporal (T006).
- H03 — desempenho como mandante e visitante melhora previsões. Plano: a análise exploratória descreve pontos por mando (
por_mando); o ganho preditivo só será avaliado em T006. - H04 — volatilidade e saldo de gols ajudam a identificar mudanças de tendência. Plano: calcular volatilidade em T005 e testá-la em backtesting (T006/T007).
- H05 — modelos de ML superam baselines estatísticos. Plano: comparação com M00 em dados de teste temporais (T006).
7. Limites
- Descrição estatística não é causalidade. Diferenças entre equipes, temporadas ou mando não são efeitos comprovados.
- Nenhuma conclusão sobre as hipóteses é tirada desta etapa.
- A fonte OpenFootball (CC0) foi auditada na etapa T002 (
docs/sources_audit.md). As outras fontes candidatas não foram aprovadas e não são usadas. - Ausências e anomalias são reportadas, não preenchidas.
8. Reprodução
python -m pip install -e ".[test,lint]"
python -B -m pytest tests/unit/test_exploratoria.py
O notebook notebooks/01_exploratoria.ipynb chama as mesmas funções. Os outputs são produzidos ao executar o notebook sobre data/processed.